A inteligência artificial não está apenas aprendendo a diagnosticar. Está aprendendo a pensar o diagnóstico.
23 de outubro de 2026
Durante anos, acompanhamos a evolução da inteligência artificial na medicina por meio de indicadores relativamente simples: desempenho em exames de certificação médica, identificação de doenças em imagens e capacidade de responder a questões clínicas complexas. Entretanto, existe uma diferença fundamental entre reconhecer um diagnóstico diante de informações previamente organizadas e conduzir uma investigação clínica quando quase nada se sabe sobre o paciente. A medicina não funciona como uma prova de múltipla escolha. O raciocínio diagnóstico exige formular hipóteses, investigar sintomas, identificar fatores de risco, interpretar achados negativos, solicitar exames apropriados e revisar continuamente as probabilidades diante de novas evidências. É precisamente essa dimensão da prática médica que começa a ser explorada por uma nova geração de sistemas de inteligência artificial. Um estudo publicado na revista Science, em 22 de outubro de 2026, apresenta resultados que merecem atenção não apenas pela precisão diagnóstica alcançada, mas pela possibilidade de transformar a própria arquitetura da tomada de decisão clínica.
Conduzida por pesquisadores da Microsoft, a investigação intitulada Sequential diagnosis with language models apresenta uma abordagem de diagnóstico sequencial baseada em grandes modelos de linguagem. Os autores desenvolveram o Sequential Diagnosis Benchmark, denominado SDBench, utilizando 304 casos de conferências clínico-patológicas publicados no New England Journal of Medicine e 325 atendimentos de emergência extraídos da base MIMIC-IV-ED. Diferentemente dos testes tradicionais, nos quais todas as informações clínicas são disponibilizadas simultaneamente, os participantes começavam com uma breve descrição do quadro e precisavam decidir quais perguntas fazer, quais exames solicitar e quando encerrar a investigação. Para executar esse processo, foi desenvolvido o Diagnostic Orchestrator, ou DxO, um sistema que simula um painel de especialistas, combina diferentes estratégias de raciocínio e revisa hipóteses diagnósticas progressivamente. A inovação metodológica está em avaliar não somente a resposta final, mas a sequência de decisões necessárias para alcançá-la.
Os resultados chamam atenção. Nos casos clínico-patológicos do New England Journal of Medicine, o DxO utilizando GPT-5 alcançou 83,2% de precisão diagnóstica, enquanto os médicos generalistas participantes, com acesso a ferramentas de pesquisa e referências, atingiram uma média de 36,1%. A comparação com médicos nessa base foi realizada em 56 casos reservados para avaliação. Nos atendimentos de emergência, a inteligência artificial apresentou precisão de 80,3%, comparada a 46,8% entre os médicos participantes. São diferenças expressivas, especialmente porque o sistema não recebeu antecipadamente todas as informações necessárias para formular suas hipóteses. Entretanto, esses percentuais representam desempenho em um ambiente experimental controlado, não taxas de acerto em atendimentos reais. Interpretar o estudo como demonstração de superioridade clínica generalizada sobre médicos seria extrapolar indevidamente seus resultados. O que foi demonstrado é uma capacidade superior de conduzir tarefas específicas de investigação diagnóstica sequencial nas condições estabelecidas pelo experimento.
Um dos aspectos mais relevantes da pesquisa, sobretudo sob a perspectiva da gestão em saúde, é a incorporação do custo dos exames como variável do raciocínio diagnóstico. A versão do DxO sem restrições orçamentárias alcançou 83,2% de precisão nos casos clínico-patológicos, com custo médio estimado de US$ 5.431 por investigação, superior aos US$ 4.725 observados entre médicos com acesso a referências. Quando o sistema passou a operar sob restrições de orçamento, manteve 80,9% de precisão com custo médio estimado de US$ 2.241. Nos casos de emergência, a configuração sem restrições atingiu 80,3% de precisão por US$ 4.979, enquanto uma configuração com orçamento limitado alcançou 73,2% por US$ 2.634. Esses valores não representam despesas efetivamente realizadas nem economias comprovadas em hospitais. Foram calculados a partir de preços padronizados de procedimentos nos Estados Unidos. Ainda assim, o experimento introduz uma discussão particularmente importante: a possibilidade de utilizar inteligência artificial para avaliar continuamente o benefício diagnóstico marginal de cada novo exame, considerando simultaneamente precisão e utilização de recursos.
Outro resultado merece uma análise mais profunda. Nos mesmos casos clínico-patológicos, os médicos realizaram, em média, 5,6 perguntas antes de solicitar o primeiro exame, enquanto o DxO formulou aproximadamente 25,5 perguntas. Essa diferença não significa que os médicos tenham necessariamente conduzido investigações inadequadas, tampouco que interrogatórios mais extensos produzam melhores resultados em qualquer circunstância. Em situações de emergência, por exemplo, postergar exames ou intervenções para aprofundar excessivamente a anamnese pode ser prejudicial. Contudo, o achado sugere que o sistema explorou sistematicamente informações clínicas antes de recorrer a investigações complementares. Essa estratégia é particularmente interessante em quadros de apresentação atípica, doenças raras, exposições epidemiológicas incomuns e condições cujos sinais discriminatórios podem estar escondidos em detalhes da história clínica. A inteligência artificial, nesse contexto, não se limita a interpretar resultados laboratoriais. Ela passa a investigar quais informações ainda precisam ser obtidas para reduzir a incerteza diagnóstica.
Do ponto de vista tecnológico, talvez a contribuição mais relevante do estudo seja demonstrar que a arquitetura de utilização dos modelos pode ser tão importante quanto sua capacidade individual. O DxO não funciona simplesmente como um chatbot médico que recebe uma pergunta e produz uma resposta. Sua estrutura organiza funções complementares de formulação de hipóteses, análise crítica, investigação adicional e avaliação econômica dos exames. Esse processo permite revisitar o diagnóstico diferencial, questionar explicações inicialmente plausíveis e reduzir a dependência de uma única linha de raciocínio. Nos testes, a orquestração aumentou a precisão média dos modelos avaliados em 7,9 pontos percentuais nos casos clínico-patológicos e 4,4 pontos percentuais nos atendimentos de emergência, em comparação com os respectivos modelos utilizados com instruções básicas. Esses resultados reforçam uma mudança importante para a inovação em saúde: o desenvolvimento de soluções clínicas não dependerá exclusivamente de modelos de linguagem mais potentes, mas também da capacidade de estruturar processos clínicos auditáveis, com diferentes mecanismos de avaliação e revisão de decisões.
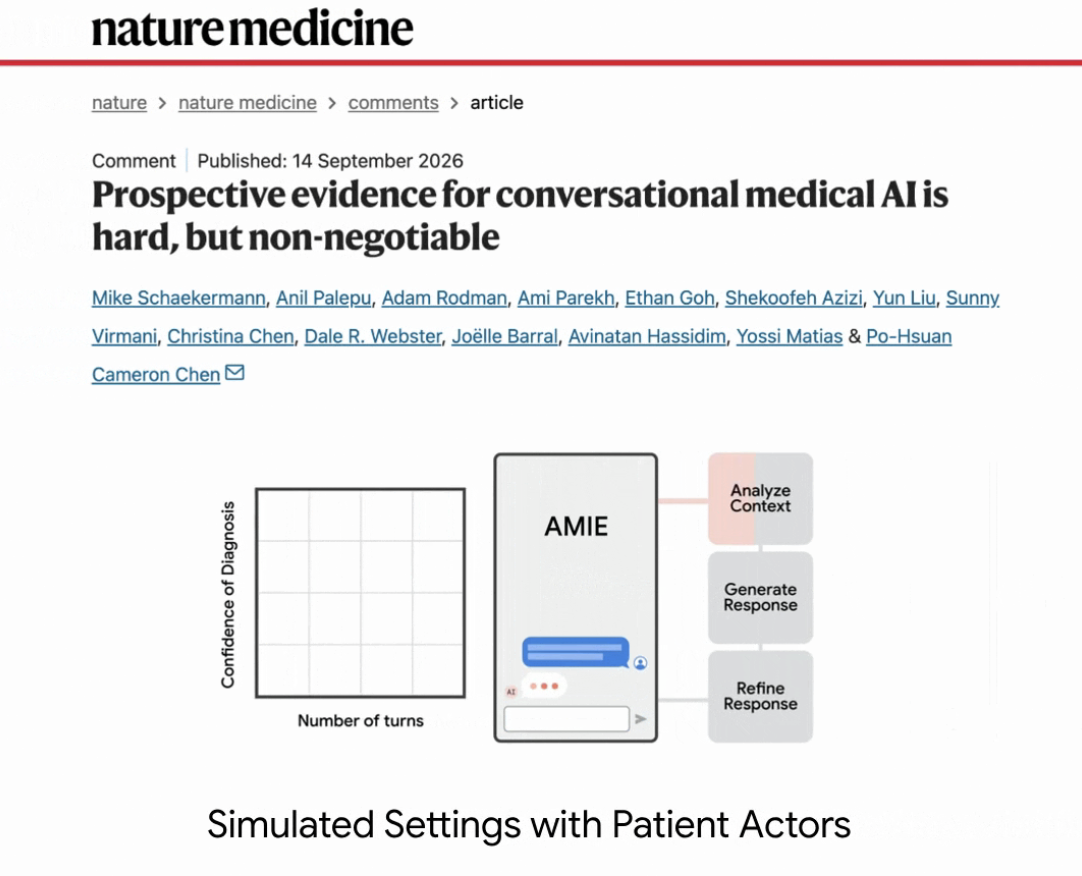
Essa evolução não ocorre isoladamente. Em abril de 2025, um estudo publicado na revista Nature apresentou o AMIE, sistema de inteligência artificial desenvolvido para realizar diálogos clínicos e construir hipóteses diagnósticas a partir de entrevistas com pacientes simulados. A pesquisa envolveu 159 cenários clínicos e comparou o desempenho do sistema com o de 20 médicos da atenção primária. O AMIE apresentou maior precisão diagnóstica e desempenho superior em 30 de 32 dimensões avaliadas por médicos especialistas, além de 25 de 26 dimensões avaliadas pelos participantes que representavam pacientes. Embora essas avaliações tenham ocorrido por conversas escritas em um ambiente experimental, os resultados convergem com os achados da Science: os modelos de linguagem estão evoluindo de ferramentas de recuperação de conhecimento médico para sistemas capazes de participar de processos dinâmicos de investigação clínica. Não estamos mais discutindo apenas a capacidade de uma máquina reconhecer determinada doença, mas sua habilidade de formular perguntas clinicamente pertinentes, identificar lacunas de informação e adaptar suas hipóteses à medida que o caso evolui.
Entretanto, existe uma diferença decisiva entre demonstrar que a inteligência artificial possui elevada capacidade diagnóstica e comprovar que sua utilização melhora o desempenho dos médicos. Um ensaio clínico randomizado publicado no JAMA Network Open, em 2024, avaliou 50 médicos e identificou que a disponibilização de um grande modelo de linguagem não produziu melhora estatisticamente significativa no desempenho diagnóstico em comparação com o uso de recursos convencionais. As pontuações medianas foram de 76% entre médicos com acesso ao modelo e 74% entre aqueles utilizando apenas recursos tradicionais, com valor de p igual a 0,60. Curiosamente, na análise exploratória, o modelo utilizado isoladamente apresentou desempenho superior ao grupo de médicos com recursos convencionais. Essa aparente contradição revela um dos grandes desafios da próxima etapa da transformação digital da saúde. Disponibilizar uma tecnologia de alto desempenho não significa incorporá-la adequadamente à prática clínica. É necessário compreender como ela influencia decisões humanas, como seus resultados são interpretados, em quais momentos deve intervir e quais mecanismos impedem tanto a confiança excessiva quanto a rejeição injustificada de suas recomendações.
É nesse ponto que considero estar uma das maiores oportunidades de inovação para hospitais, clínicas, laboratórios e sistemas de saúde. Imagine uma infraestrutura digital capaz de acompanhar longitudinalmente a investigação diagnóstica, integrar informações disponíveis no prontuário, sugerir perguntas ainda não realizadas, identificar inconsistências entre achados clínicos e hipóteses propostas e apoiar a escolha de exames com maior potencial de modificar uma decisão. Em um laboratório de medicina diagnóstica, por exemplo, sistemas dessa natureza poderiam futuramente contribuir para contextualizar solicitações e resultados, desde que integrados à avaliação médica e submetidos à validação adequada. Na atenção primária, poderiam apoiar profissionais diante de apresentações clínicas inespecíficas e auxiliar na identificação de situações que justificam investigação adicional ou encaminhamento especializado. Nenhuma dessas aplicações foi clinicamente validada pelo estudo da Science. São possibilidades de desenvolvimento que emergem de sua arquitetura e precisam ser testadas prospectivamente. A transformação mais relevante talvez não seja a automação do diagnóstico, mas a construção de sistemas que organizem melhor a investigação, reduzam a fragmentação das informações e contribuam para decisões mais consistentes.
Apesar do entusiasmo legítimo, algumas limitações metodológicas precisam permanecer no centro dessa discussão. O SDBench utilizou casos retrospectivos e interações baseadas exclusivamente em texto, com informações fornecidas por um agente intermediário a partir de registros previamente existentes. Quando determinados dados não estavam disponíveis, esse agente podia gerar respostas sintéticas neutras para evitar pistas artificiais sobre o diagnóstico. Além disso, os conjuntos avaliados não representavam a distribuição completa das condições encontradas na assistência, pois excluíam atendimentos de pessoas saudáveis ou com condições benignas. Também não foram consideradas diretamente imagens médicas, traçados fisiológicos, lâminas anatomopatológicas, respostas às intervenções terapêuticas e diversas particularidades da relação entre profissionais e pacientes. A classificação dos diagnósticos foi realizada por outro agente de inteligência artificial, utilizando critérios elaborados por médicos. O estudo não avaliou segurança terapêutica, evolução longitudinal nem desfechos clínicos. É importante observar, ainda, que a pesquisa foi desenvolvida com recursos da Microsoft e que os autores declararam vínculo empregatício e participação acionária na empresa. Esses elementos não invalidam os resultados, mas reforçam a importância da replicação independente.
Para os gestores e desenvolvedores de tecnologias em saúde, a questão passa a ser como transformar essa capacidade experimental em benefício assistencial mensurável. Em setembro de 2026, pesquisadores publicaram na Nature Medicine um comentário defendendo que a confiança na inteligência artificial clínica não pode ser estabelecida apenas por benchmarks, exigindo estudos prospectivos rigorosos em ambientes reais. Essa perspectiva dialoga com as orientações da Organização Mundial da Saúde sobre governança de modelos de inteligência artificial, que destacam riscos relacionados a respostas incorretas, vieses, privacidade e confiança excessiva na automação. Uma implementação responsável precisará avaliar não apenas concordância diagnóstica, mas também eventos adversos, exames desnecessários, tempo até decisões relevantes, custo total do cuidado, diferenças de desempenho entre populações e impacto sobre o comportamento dos profissionais. Para o Brasil, essa agenda deverá considerar a heterogeneidade da infraestrutura digital, a diversidade epidemiológica e as diferentes condições de acesso aos serviços de saúde. Resultados obtidos em bases norte-americanas não podem ser automaticamente transferidos para a realidade do SUS ou da saúde suplementar brasileira.
O estudo publicado na Science representa, portanto, mais do que uma nova demonstração de desempenho da inteligência artificial em medicina. Ele aponta para uma mudança na maneira como podemos desenvolver tecnologias de apoio à decisão clínica. Durante muito tempo, buscamos sistemas capazes de fornecer respostas corretas a perguntas formuladas por profissionais. Agora começamos a investigar sistemas capazes de colaborar na construção das próprias perguntas, revisar hipóteses e considerar o valor das informações antes de recomendar novas etapas da investigação. Isso não elimina a necessidade de julgamento médico, especialmente diante das dimensões humanas, éticas e terapêuticas que não foram avaliadas nesses experimentos. Ao contrário, amplia a importância de compreender como o profissional poderá supervisionar, questionar e utilizar essas capacidades com segurança. Na minha perspectiva, o futuro da inteligência artificial na saúde não será definido apenas por qual modelo apresenta a maior taxa de acerto, mas por nossa capacidade de integrar essa inteligência ao processo assistencial de maneira cientificamente validada. A próxima fronteira não é simplesmente fazer a máquina diagnosticar melhor. É descobrir como médicos e sistemas inteligentes podem construir, juntos, decisões clínicas melhores.
Leia outros artigos
Diretrizes clínicas na era da inteligência artificial: estamos preparados para reinventar a medicina baseada em evidências?
21 de outubro de 2026
A inteligência artificial está transformando a medicina. Mas os hospitais estão preparados para assumir essa responsabilidade?
8 de outubro de 2026